跳至主要內容

RL6 - 随机近似理论与随机梯度下降算法

academic强化学习约 1548 字大约 5 分钟

  • 针对 mean estimation 问题进行研究,因为在 RL 中 无论是 state value 还是 action value 其定义都是一个均值 (means)

  • Stochastic approximation(SA): SA refers to a broad class of stochastic iterative algorithms soloving root finding or optimization problems.

1. 引言

1.1 求均值的方法

  • 第一种:直接通过 E[x]≈xˉ:=1N∑i=1NxiE[x]\approx \bar{x} := \frac{1}{N}\sum_{i=1}^N x_i,进行估计,只有当样本全部收集完才能估计.

  • 第二种: 增量式的迭代算法.
    假设:

    wk+1=1k∑i=1kxi,k=1,2,… w_{k+1}=\frac{1}{k}\sum_{i=1}^kx_i,\quad k=1,2,\dots

    对应的

    wk=1k−1∑i=1k−1xi,k=2,3,… w_k=\frac{1}{k-1}\sum_{i=1}^{k-1}x_i,\quad k=2,3,\dots

    那么,wk+1w_{k+1}可以由wkw_k推导出来,即

    wk+1=1k∑i=1kxi=1k(∑i=1k−1xi+xk)=1k((k−1)wk+xk)=wk−1k(wk−xk) \begin{array}{llll} w_{k+1} & =\frac{1}{k}\sum_{i=1}^kx_i & =\frac{1}{k}(\sum_{i=1}^{k-1}x_i+x_k) & \\ & & =\frac{1}{k}((k-1)w_k+x_k) & = w_k-\frac{1}{k}(w_k-x_k) \end{array}

    因此,wk+1=wk−1k(wk−xk)\color{blue}{w_{k+1}=w_k-\frac{1}{k}(w_k-x_k)}

2. Robbins-Monto(RM) algorithm

2.1 问题引入

假设我们需要求解如下方程:

g(w)=0 g(w)=0

其中, w∈Rw\in \reals 且需要被求解出来,g:R→Rg:\reals \rightarrow \reals 为一个函数方程.
显然,如果对于 g(w)g(w) 已知的情况,我们可以通过一些特定的算法进行求解。
如果 g(w)g(w) 未知,就需要新的算法进行解决。

2.2 算法介绍

RM 算法就可以用来求解当 g(w)g(w) 未知时的情况,即函数 g(w)g(w) 是一个黑盒,我们只能通过 输入序列: wk{w_k}, 得到含有噪音的观测值序列: gˇ(wk,ηk)\widecheck{g}(w_k,\eta_k)
具体解决如下:

wk+1=wk−akg~(wk,ηk),k=1,2,3,… w_{k+1}=w_k-a_k\widetilde{g}(w_k,\eta_k),\quad k=1,2,3,\dots

其中:

  • wkw_k 是第 k 次方程根的估计.
  • g~(wk,ηk)=g(wk)+ηk\widetilde{g}(w_k,\eta_k)=g(w_k)+\eta_k 是第 k 次的观测值(含噪音).
  • aka_k 是一个 positive coefficient.

2.3 收敛性分析

Robbins-Monro Theorem
In the Robbins-Monro algorithm, if

  1. 0<c1≤▽wg(w)≤c2,for all w;0<c_1\le \bigtriangledown_w g(w) \le c_2, \quad for\space all \space w; 要求g(w)g(w)必须是递增的,确保根是存在且唯一的。

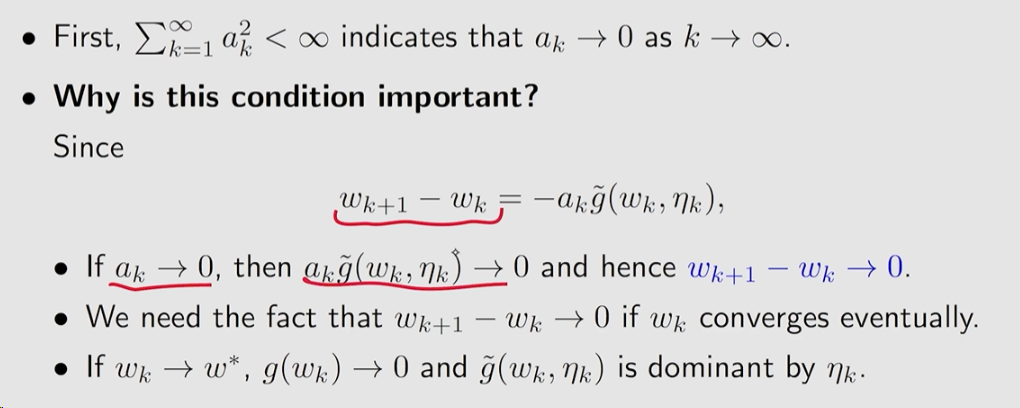
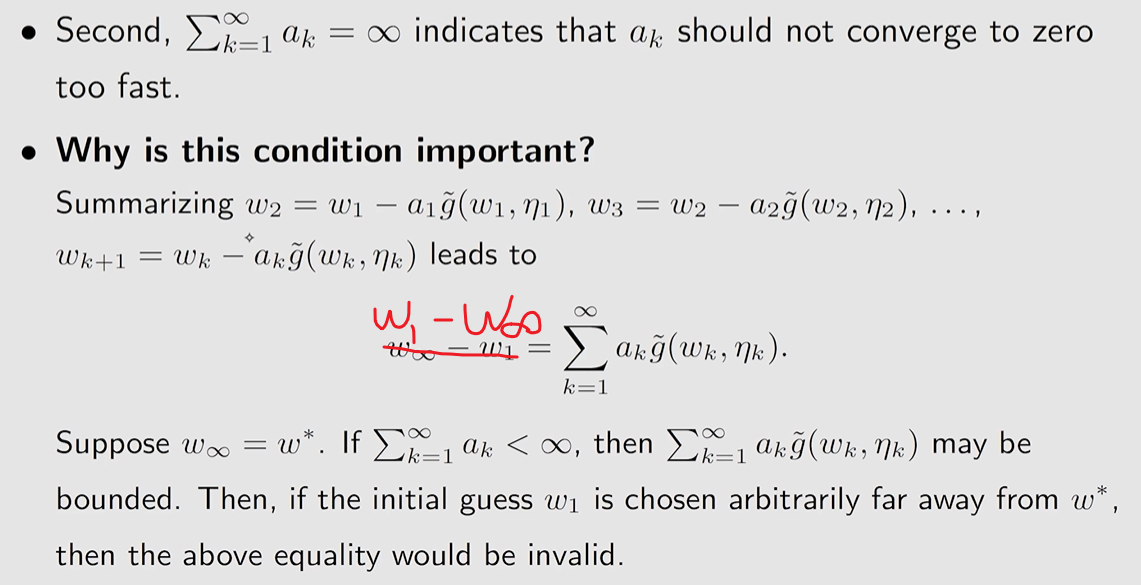
  2. ∑k=1∞ak=∞\sum_{k=1}^{\infty}a_k=\infty 且 ∑k=1∞ak2<∞;\sum_{k=1}^{\infty}a_k^2<\infty;∑k=1∞ak2=∞\sum_{k=1}^{\infty}a_k^2=\infty 保证 ak→0,k→0a_k \rightarrow 0, \quad k \rightarrow 0
    20240814002323∑k=1∞ak=∞\sum_{k=1}^{\infty}a_k=\infty 保证 ak→0a_k \rightarrow 0不要过快.
    20240814002309

  3. E[ηk∣Hk]=0E[\eta_k|\mathcal{H}_k]=0 且 E[ηk2∣Hk]<∞;E[\eta_k^2|\mathcal{H}_k]<\infty; 其中Hk=wk,wk−1,…\mathcal{H}_k={w_k,w_{k-1},\dots}, 那么 wkw_k converges with probability 1 (w.p.1) to the root w∗w^* satisfying g(w∗)=0g(w^*)=0.

ak=1ka_k = \frac{1}{k}是满足上面三个条件的. 但实际上我们往往是选择一个非常小的常数。

2.4 应用于 mean estimation 中

比如我们要估计某个随机变量X的 E[X]E[X]
我们可以设计如下方程:

g(w)≐w − E[X]. g(w)\doteq w\space - \space \mathbb{E}[X].

那么只要求解 g(w)=0g(w)=0, 我们就可以得到 E[X]\mathbb{E}[X] 的值。
同样,我们不能直接得到随机变量的值,而是对应的样本 xx,sample of XX. 即,我们得到的观测值是:

g~(w,x)≐w−x \widetilde{g}(w,x)\doteq w - x

我们可以修改为噪音 η\eta 的形式,

g~(w,η)=w−x=w−x+E[X]−E[X]=(w−E[X])+(E[X]−x)≐g(w)+η \begin{array}{llll} \widetilde{g}(w,\eta) & =w-x & =w-x+\mathbb{E}[X]-\mathbb{E}[X] & \\ & &=(w-\mathbb{E}[X])+(\mathbb{E}[X]-x) & \doteq g(w)+\eta \end{array}

因此我们可以通过 RM 算法来进行求解

wk+1=wk−αkg~(wk,ηk)=wk−αk(wk−xk) w_{k+1}=w_k-\alpha_k \widetilde{g}(w_k,\eta_k)=w_k-\alpha_k(w_k-x_k)

3. Stochastic gradient descent

3.1 问题引入

需要求解一个优化问题:

arg min⁡w J(w)=E[f(w,X)] \argmin_w \space J(w)=\mathbb{E}[f(w,X)]

其中,

  • ww 是需要被优化的参数
  • XX 是一个随机变量
  • ww 和 XX 可以是标量,也可以是向量. 对于函数 f(⋅)f(\cdot) 输出为标量.

对于这个问题,我们有以下几种方法:

  • Method 1: 梯度下降法 (gradient descent, GD)

    wk+1=wk−αk▽wE[f(wk,X)]=wk−αkE[▽wf(wk,X)] w_{k+1} =w_k-\alpha_k \bigtriangledown_w\mathbb{E}[f(w_k,X)] =w_k-\alpha_k \mathbb{E}[\bigtriangledown_w f(w_k,X)]

    但由于 j(w)j(w) 是一个期望值,我们很难直接获得.

  • Method 2: batch gradient descent (BGD) 借用 MC 的思想,我们可以将:

    E[▽wf(wk,X)]≈1n∑i=1n▽wf(wk,xi). \mathbb{E}[\bigtriangledown_w f(w_k,X)] \approx \frac{1}{n}\sum_{i=1}^n\bigtriangledown_w f(w_k,x_i).

    因此

    wk+1=wk−αk1n∑i=1n▽wf(wk,xi) w_{k+1} =w_k-\alpha_k \frac{1}{n}\sum_{i=1}^n\bigtriangledown_w f(w_k,x_i)

    但需要大量的 samples 收集完毕才能进行一次迭代.

  • Method 3: 随机梯度下降(SGD) 考虑能否仅用一次 sample 进行迭代.

    wk+1=wk−αk▽wf(wk,xk) w_{k+1} =w_k-\alpha_k \bigtriangledown_w f(w_k,x_k)

    但能否保证其精确度,以及是否可以到最后优化的成果。

3.2 SGD 分析

mean estimation 问题转化

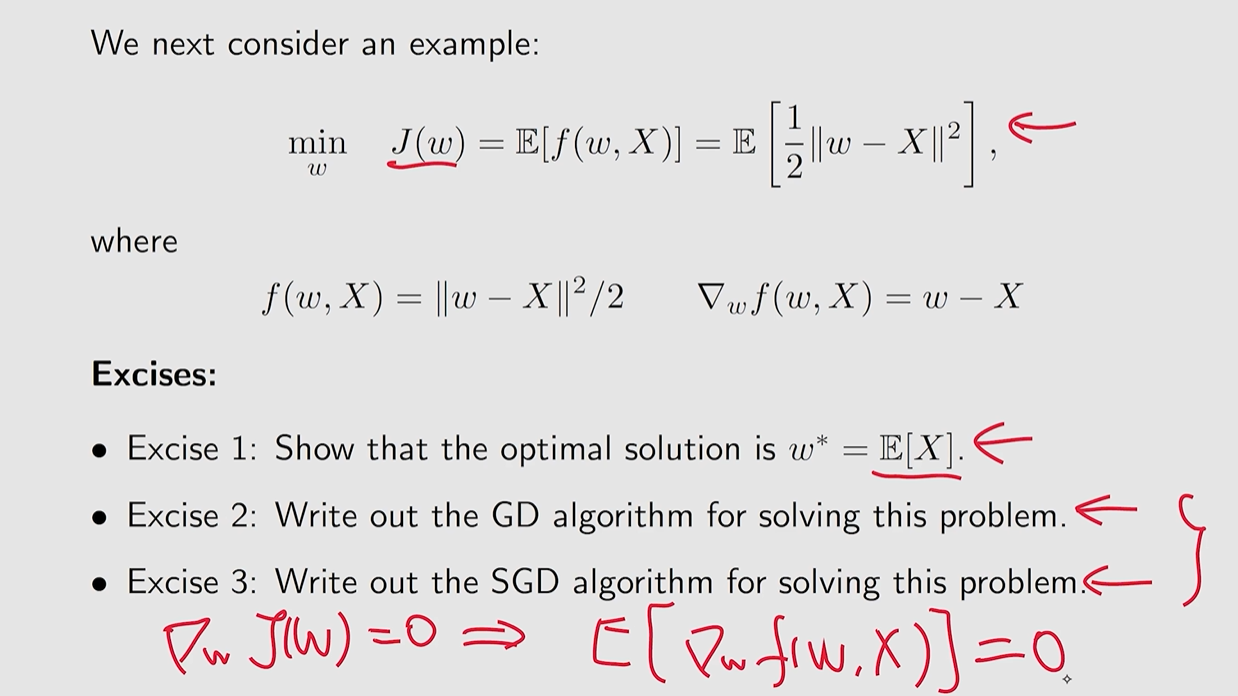
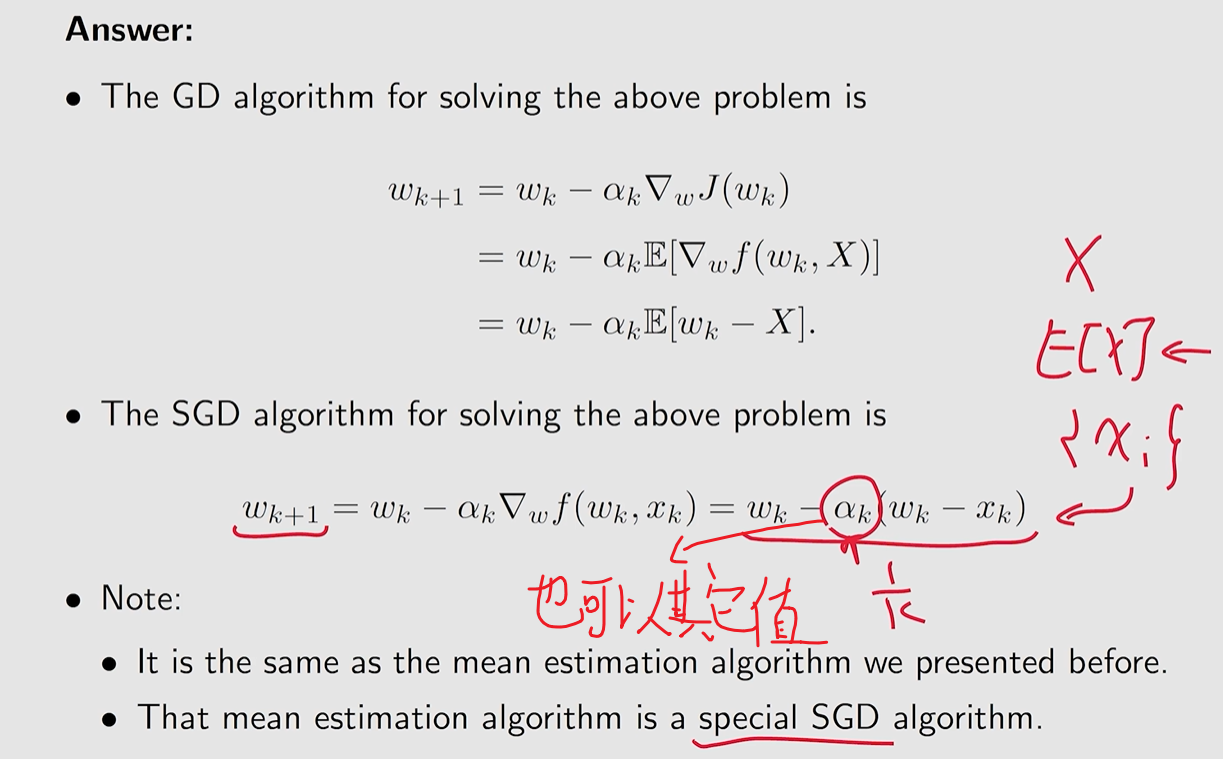
我们可以将 均值估计 问题 转化为 一个 优化问题 进行求解:
20240814013856

  • 20240814014058
    20240814014058

SGD 正确性和收敛性分析

从 GD 到 SGD:

wk+1=wk−αkE[▽wf(wk,X)]⇓wk+1=wk−αk▽wf(wk,x) \begin{matrix} w_{k+1}=w_k-\alpha_k\mathbb{E}[\bigtriangledown_w f(w_k,X)] \\ \Downarrow \\ w_{k+1}=w_k-\alpha_k\bigtriangledown_w f(w_k,x) \end{matrix}

显然我们可以将 ▽wf(wk,x)\bigtriangledown_w f(w_k,x) 视为 E[▽wf(wk,x)]\mathbb{E}[\bigtriangledown_w f(w_k,x)] 的一个观测值(含噪声):

▽wf(wk,x)=E[▽wf(wk,x)]+▽wf(wk,x)−E[▽wf(wk,x)]⏟η \bigtriangledown_w f(w_k,x)=\mathbb{E}[\bigtriangledown_w f(w_k,x)] + \underset{\eta}{\underbrace{ \bigtriangledown_w f(w_k,x)-\mathbb{E}[\bigtriangledown_w f(w_k,x)] }}

因为

▽wf(wk,x)≠E[▽wf(wk,x)] \bigtriangledown_w f(w_k,x) \neq \mathbb{E}[\bigtriangledown_w f(w_k,x)]

因此,我们需要思考使用 SGD 时wk→w∗w_k \rightarrow w^* as k→∞k\rightarrow \infty 是否成立。

我们可以将 SGD 视为一个特殊情况下的 RM 算法
SGD的目标是 minimize

J(w)=E[f(w,X)] J(w)=\mathbb{E}[f(w,X)]

而最小值问题,往往可以转化为导数为 0 的情况,

▽wJ(w)=E[▽wf(w,X)]=0 \bigtriangledown_w J(w)=\mathbb{E}[\bigtriangledown_w f(w,X)]=0

显然,可以参考 RM 算法, 让

g(w)=▽wJ(w)=E[▽wf(w,X)] g(w) = \bigtriangledown_w J(w)=\mathbb{E}[\bigtriangledown_w f(w,X)]

从而转换为一个 root-finding 问题.
相应的,对于观测值g~(w,η)\widetilde{g}(w,\eta),

g~(w,η)=∇wf(w,x)=E[∇wf(w,X)]⏟g(w)+∇wf(w,x)−E[∇wf(w,X)]⏟η. \begin{aligned} \tilde{g}(w, \eta) & =\nabla_{w} f(w, x) \\ & =\underbrace{\mathbb{E}\left[\nabla_{w} f(w, X)\right]}_{g(w)}+\underbrace{\nabla_{w} f(w, x)-\mathbb{E}\left[\nabla_{w} f(w, X)\right]}_{\eta} . \end{aligned}

因此,我们就可以通过 RM 算法进行求解g(w)=0g(w)=0,

wk+1=wk−αkg~(wk,ηk)=wk−αk▽wf(wk,xk) w_{k+1}=w_k-\alpha_k\widetilde{g}(w_k,\eta_k)=w_k-\alpha_k\bigtriangledown_w f(w_k,x_k)

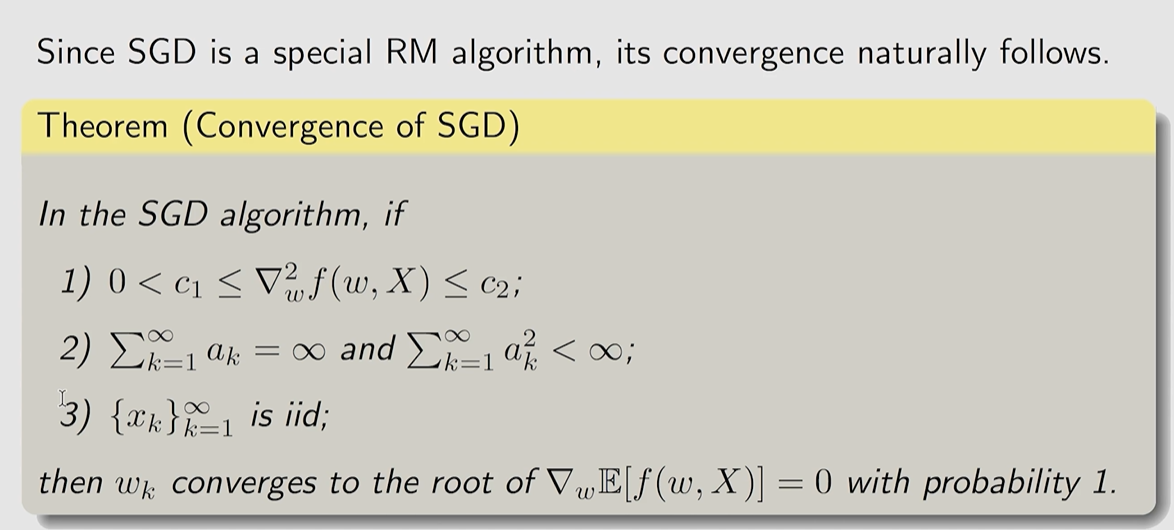
对应收敛性证明
20240814013746

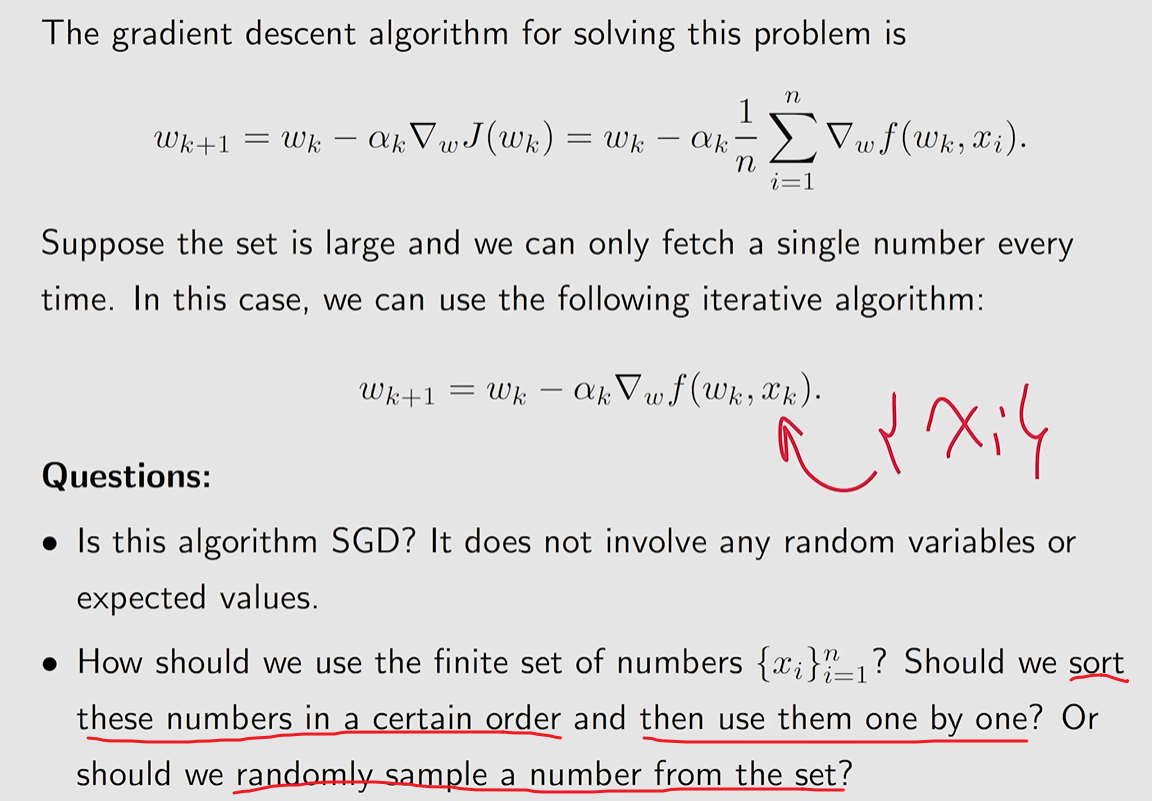
3.3 SGD 另一种问题描述方法 (deterministic formulation)

在之前关于使用 SGD 算法的问题描述中,我们是引入了 随机变量 和 期望的情况.
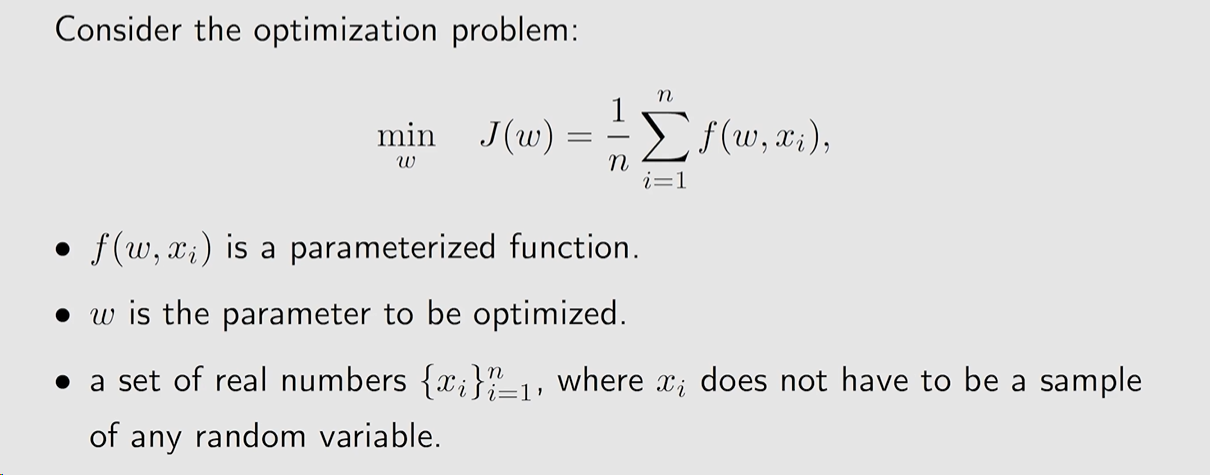
20240814230431 我们可以将这个问题可以转化为一个随机变量的方法,从而引入 SGD 算法.
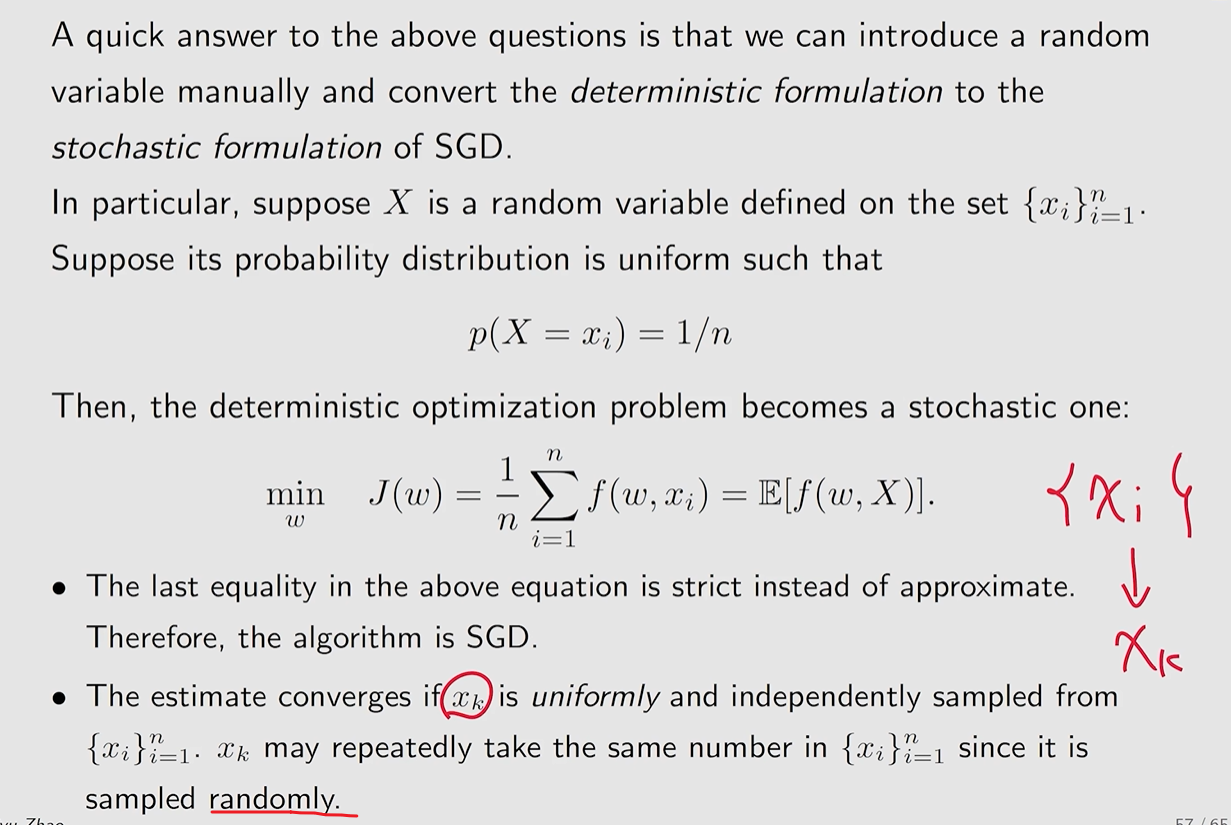
2024081423060620240814230650

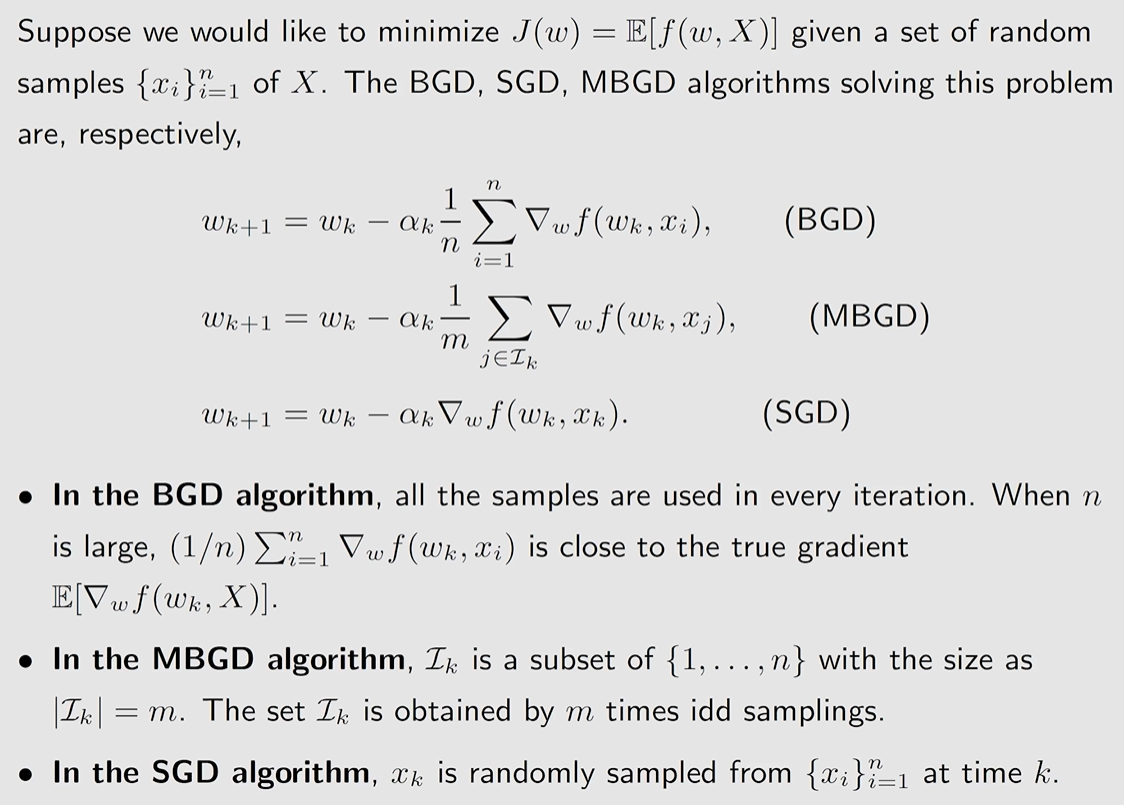
3.4 BGD MBGD SGDw

20240814230747
20240814230747
上次编辑于: