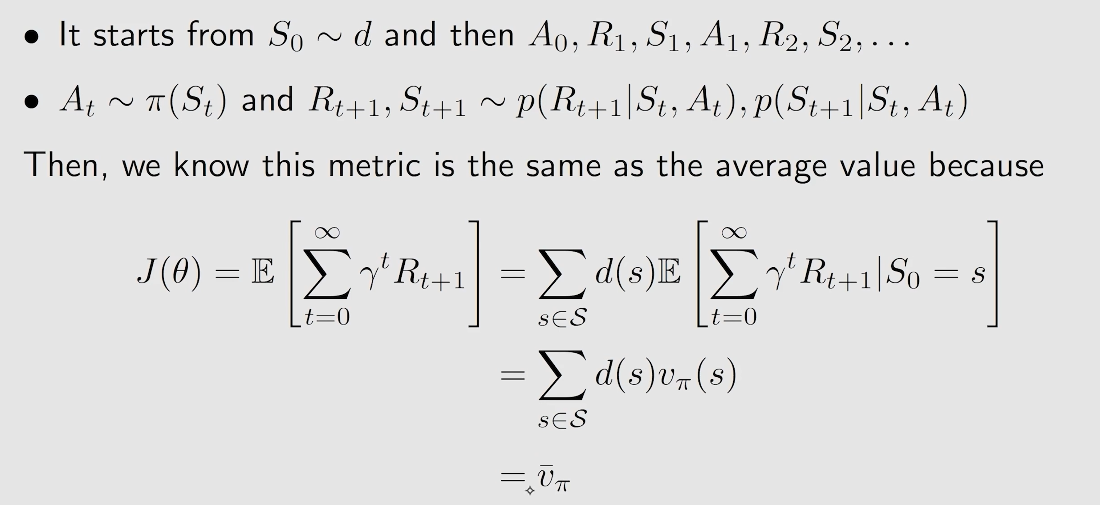跳至主要內容

RL9 - 策略梯度法(Policy gradient)

academic强化学习约 1285 字大约 4 分钟

  • 之前介绍的方法都是 value-based 的方法,从这章开始时基于 policy-based 的方法。
  • policy function approximation 是直接建立一个基于策略的目标函数来进行梯度上升的优化。

1. 基本思路

将基于表格表示的策略 转换为 基于函数表示的策略。
即此时策略 π\pi 可以描述为:

π(a∣s,θ) \pi(a|s,\theta)

其中,θ∈Rm\theta\in \mathbb{R}^m表示参数向量,是我们需要进行优化的。

  • 当策略是以表格的形式保存时,我们定义最优的策略为 在该策略下的所有 state value 都是最大的。
  • 当策略是以函数的形式存在时,我们定义 最优的策略 为 可以最大化一个确定的常数指标(certain scalar metrics).

Policy gradient 的基本步骤:

  • 确定 metrics/objective function,来定义最优的策略:J(θ)J(\theta)
  • 进行优化,如梯度上升算法

θt+1=θt+α▽θJ(θt) \theta_{t+1} = \theta_t+\alpha \triangledown_\theta J(\theta_t)

2. 目标函数定义

2.1 average state value

vˉπ=∑s∈Sd(s)vπ(s)=dTvπ \bar{v}_\pi = \sum_{s\in S}d(s)v_\pi(s) = d^Tv_\pi

  • vˉπ\bar{v}_\pi 显然是 state value 的加权平均。
  • d(s)≥0d(s)\ge 0 是各个 state 的权重
  • ∑s∈Sd(s)=1\sum_{s\in S}d(s)=1, 我们可以认为 d(s)d(s) 是 概率分布,因此该指标可以描述为:

vˉπ=ES∼d[vπ(S)] \bar{v}_\pi = \mathbb{E}_{S \sim d}[v_\pi(S)]

vˉπ\bar{v}_\pi 另一种表达

J(θ)=E[∑t=0∞γtRt+1] J(\theta) = \mathbb{E}[\sum_{t=0}^\infty \gamma^t R_{t+1}]

20240826173749
20240826173749

d(s)的选择

  • d 与策略 π\pi 无关
    这种情况我们将 d 表示为 d0d_0, vˉπ\bar{v}_\pi 表示为 vˉπ0\bar{v}_\pi^0.
    这种情况下的 d 可以根据对各个状态的重要程度进行选择:
    一种是将所有状态视为同等重要,一种则是有所偏向。

  • d 与策略 π\pi 有关 dd 表示为 dπ(s)d_\pi(s), 即在策略 π\pi 下的 stationary distribution。

2.2 average return value

rˉπ=∑s∈Sdπ(s)rπ(s)=ES∼d[rπ(s)] \bar{r}_\pi = \sum_{s\in S}d_\pi(s)r_\pi(s) = \mathbb{E}_{S \sim d}[r_\pi(s)]

其中:

rπ(s)≐∑a∈Aπ(a∣s)r(s,a)r(s,a)=E[R∣s,a]=∑rrp(r∣s,a) \begin{aligned} r_\pi(s) & \doteq \sum_{a\in \mathcal{A}}\pi(a|s)r(s,a) \\ r(s,a) & = \mathbb{E}[R|s,a]=\sum_r r p(r|s,a) \end{aligned}

rπ(s)r_\pi(s)表示在策略π\pi下 状态s时可以得到的平均reward。
r(s,a)r(s,a)表示在单步情况下(在状态s采用动作a)时的平均reward。

rˉπ\bar{r}_\pi 另一种表达

假设 agent 跟随一个 给定的策略 然后生成了一个 trajectory以及对应的 rewards (Rt+1,Rt+2,… )(R_{t+1},R_{t+2},\dots)

对应 average single-step reward along this trajectory is

lim⁡n→∞1nE[Rt+1+Rt+2+⋯+Rt+n∣St=s0]=lim⁡n→∞1nE[∑k=1nRt+k∣St=s0]=lim⁡n→∞1nE[∑k=1nRt+k]=∑sdπ(s)rπ(s)= rˉπ \begin{aligned} & \lim_{n \rightarrow \infty} \frac{1}{n} \mathbb{E}[R_{t+1}+R_{t+2}+\dots+R_{t+n}|S_t = s_0] \\ = & \lim_{n \rightarrow \infty} \frac{1}{n} \mathbb{E}[\sum_{k=1}^nR_{t+k}|S_t = s_0] \\ = & \lim_{n \rightarrow \infty} \frac{1}{n} \mathbb{E}[\sum_{k=1}^nR_{t+k}] \\ = & \sum_s d_\pi(s)r_\pi(s) \\ = & ~ \bar{r}_\pi \end{aligned}

3. 目标函数梯度求解

这里在视频没有详细介绍,只给出了梯度的公式:

▽θJ(θ)=∑s∈Sη(s)∑a∈A▽θπ(a∣s,θ)qπ(s,a)=E[▽θlnπ(A∣S,θ)qπ(S,A)] \begin{aligned} \triangledown_\theta J(\theta) & =\sum_{s\in \mathcal{S}}\eta(s) \sum_{a\in\mathcal{A}}\triangledown_{\theta}\pi(a|s,\theta)q_\pi(s,a) \\ &= \textcolor{red}{\mathbb{E}[\triangledown_\theta ln\pi(A|S,\theta)q_\pi(S,A)]} \end{aligned}

其中

  • J(θ)J(\theta) 可以是 vˉπ, rˉπ, vˉπ0\bar{v}_\pi, \space \bar{r}_\pi, \space \bar{v}_\pi^0 任何一种。
  • "==" 有表示 严格等于 近似 以及 成比例等于
  • η\eta 表示 state 的权重或者分布

具体推导过程:

▽θlnπ(a∣s,θ)=▽θπ(a∣s,θ)π(a∣s,θ)▽θJ(θ)=∑s∈Sd(s)∑a∈A▽θπ(a∣s,θ)qπ(s,a)=∑s∈Sd(s)∑a∈Aπ(a∣s,θ)▽θln⁡π(a∣s,θ)qπ(s,a)=ES∼d[∑aπ(s∣S,θ)▽θln⁡π(a∣S,θ)qπ(S,a)]=ES∼d, A∼π[▽θln⁡π(A∣S,θ)qπ(S,A)]≐E[▽θlnπ(A∣S,θ)qπ(S,A)] \begin{aligned} \triangledown_\theta ln \pi(a|s,\theta) & = \frac{\triangledown_\theta \pi(a|s,\theta)}{\pi(a|s,\theta)} \\\\ \triangledown_\theta J(\theta) & =\sum_{s\in \mathcal{S}}d(s) \sum_{a\in\mathcal{A}}\textcolor{blue}{\triangledown_{\theta}\pi(a|s,\theta)}q_\pi(s,a) \\ & = \sum_{s\in \mathcal{S}}d(s) \sum_{a\in\mathcal{A}} \textcolor{blue}{\pi(a|s,\theta)\triangledown_{\theta}\ln\pi(a|s,\theta)}q_\pi(s,a) \\ & = \mathbb{E}_{\textcolor{blue}{S \sim d}}[\sum_a \pi(s|S,\theta)\triangledown_{\theta}\ln\pi(a|S,\theta)q_\pi(S,a)] \\ & = \mathbb{E}_{\textcolor{blue}{S \sim d, ~ A \sim \pi}}[\triangledown_{\theta}\ln\pi(A|S,\theta)q_\pi(S,A)] \\ & \doteq \textcolor{red}{\mathbb{E}[\triangledown_\theta ln\pi(A|S,\theta)q_\pi(S,A)]} \end{aligned}

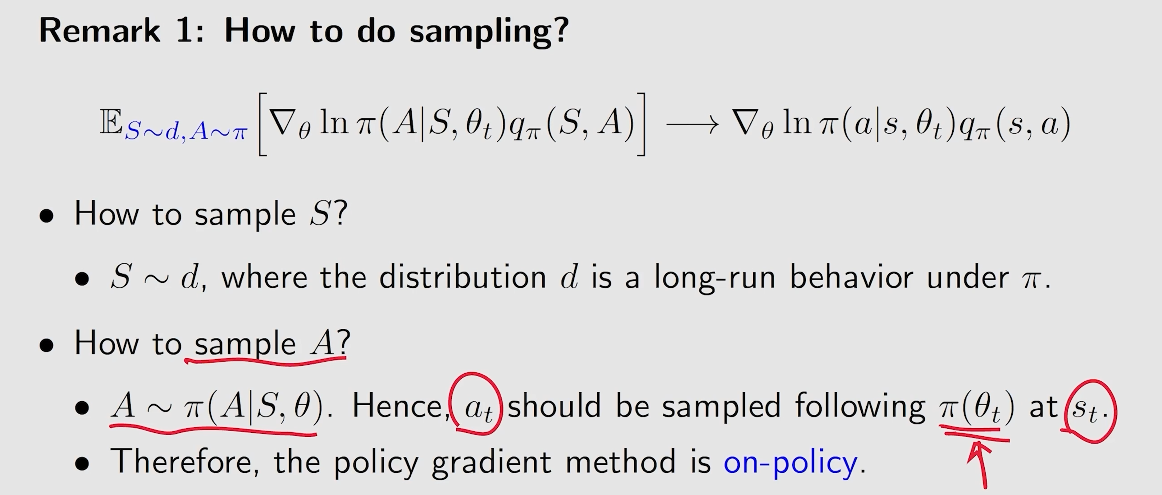
根据这个式子我们就可以通过 SGD 方法,从而可以进行近似求解:

▽θJ(θ)≈▽θlnπ(a∣s,θ)qπ(s,a) \triangledown_\theta J(\theta) \approx \triangledown_\theta ln\pi(a|s,\theta)q_\pi(s,a)

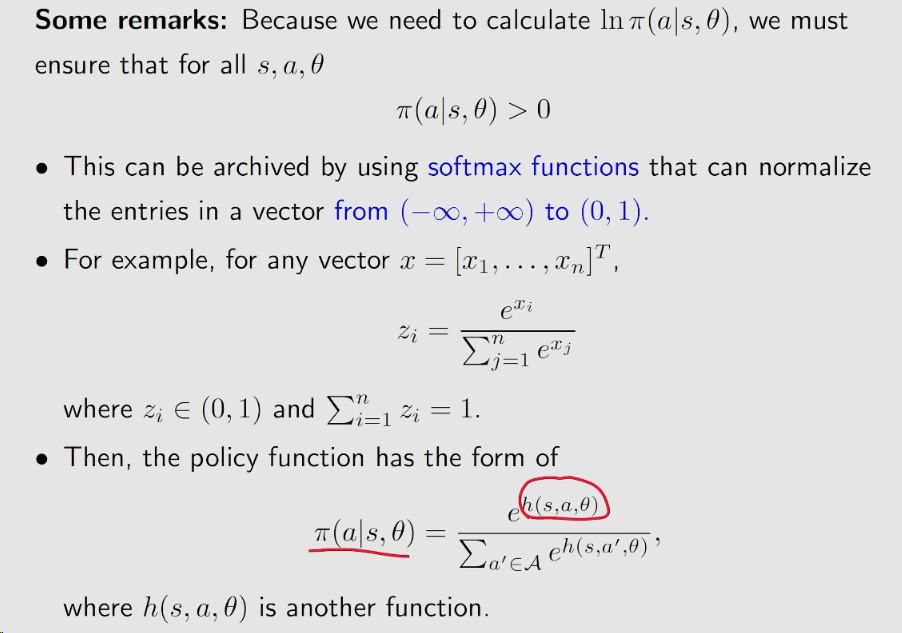
一些特性 这里的策略是随机性 的,因为我们需要计算的是 lnπ(a∣s,θ)ln\pi(a|s,\theta), 因此我们需要保证对于所有的 s,a,θs,a,\theta

π(a∣s,θ)≥0 \pi(a|s,\theta) \ge 0

20240826180244
20240826180244

4. REINFORCE 梯度上升算法

梯度上升算法的本质就是最大化目标函数 J(θ)J(\theta)

θt+1=θt+α▽θJ(θ)=θt+αE[▽θlnπ(A∣S,θt)qπ(S,A)] \begin{aligned} \theta_{t+1} & = \theta_t + \alpha \triangledown_\theta J(\theta) \\ & = \theta_t + \alpha\mathbb{E}[\triangledown_\theta ln\pi(A|S,\theta_t)q_\pi(S,A)] \end{aligned}

而对应的真实梯度可以用一个估计的梯度来替代:

θt+1=θt+α▽θln⁡π(at∣st,θt)qπ(s,a) \theta_{t+1} = \theta_t + \alpha \triangledown_\theta \ln\pi(a_t|s_t,\theta_t)q_\pi(s,a)

但还存在 qπ(s,a)q_\pi(s,a) 是未知的,我们也可以进行近似:

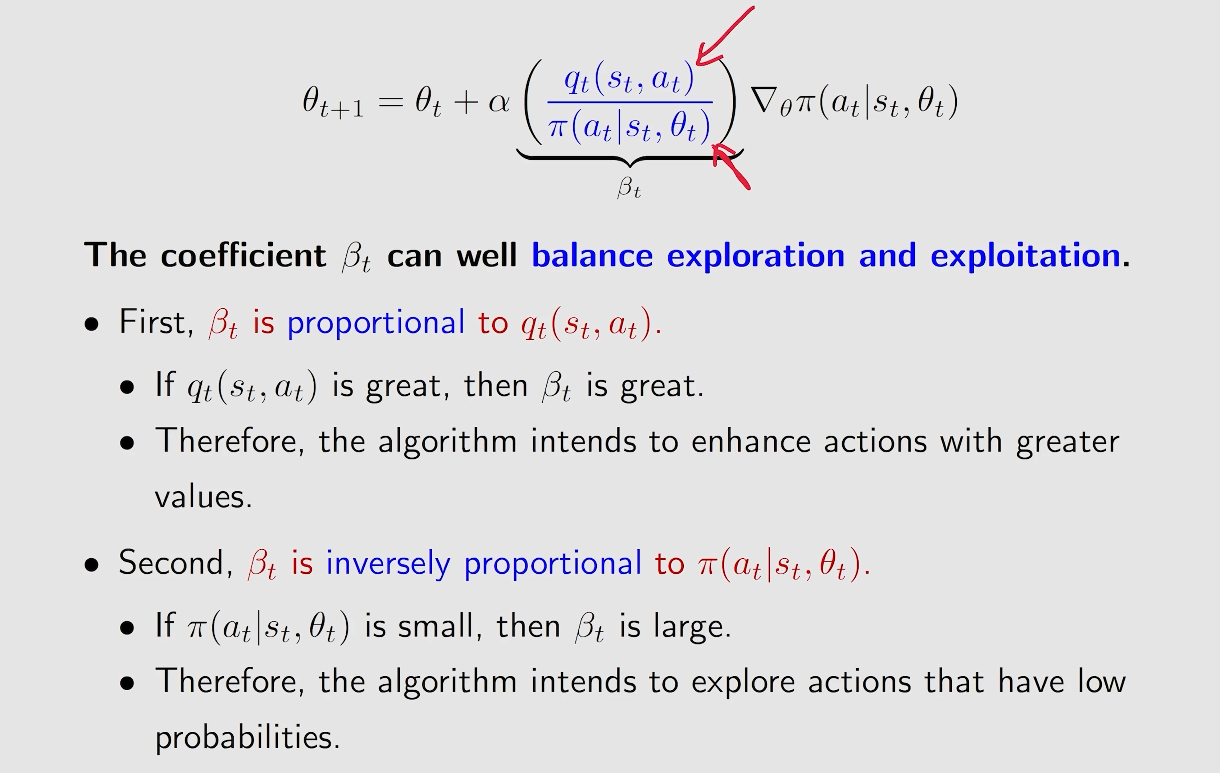
θt+1=θt+α▽θlnπ(a∣s,θt)qt(st,at) \theta_{t+1} = \theta_t + \alpha \triangledown_\theta ln\pi(a|s,\theta_t) \textcolor{blue}{q_t(s_t,a_t)}

这里可以用不同的方法来近似 qπ(s,a)q_\pi(s,a).

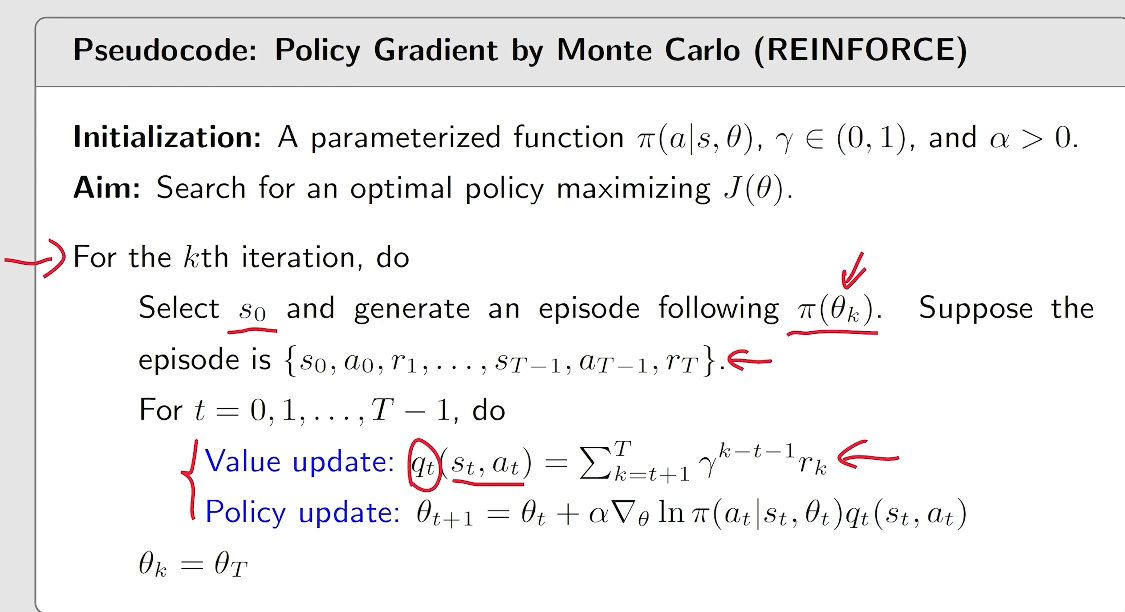
  • Monte-Carlo based method, 我们便称为 REINFORCE
  • 也可以采用基于 TD 的算法 或者 其他的算法。

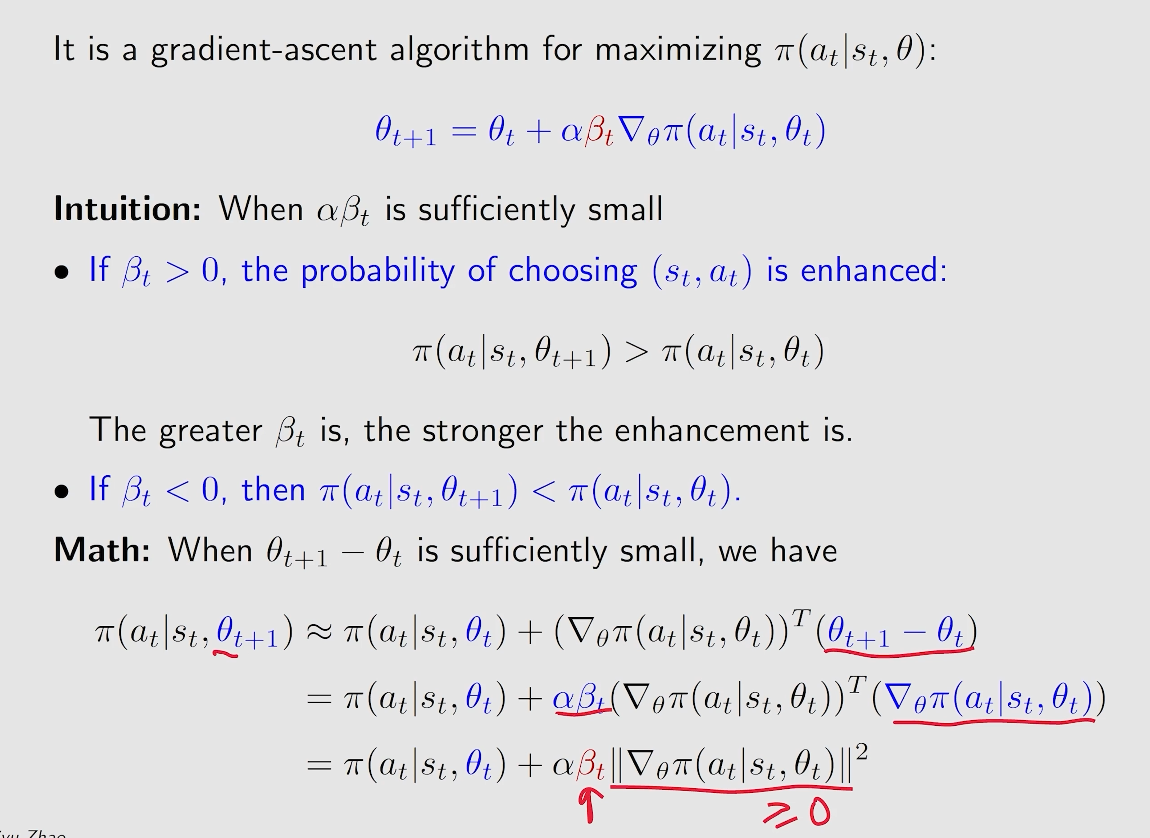
一些细节

20240826181340
20240826181340
20240826181538
20240826181538
20240826181638
20240826181638

REINFORCE 算法

20240826181712
20240826181712
上次编辑于: